Domain faah.de kaufen?
Wir ziehen mit dem Projekt
faah.de um.
Sind Sie am Kauf der Domain
faah.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain faah.de kaufen?
Welche Datenquellen werden zur Bereitstellung von aktuellen Straßeninformationen genutzt?
Zur Bereitstellung von aktuellen Straßeninformationen werden Datenquellen wie GPS-Daten von Fahrzeugen, Verkehrsüberwachungskameras und Sensoren an Straßeninfrastruktur genutzt. Zudem werden auch Daten von Verkehrsinformationsdiensten, Navigationssystemen und Mobilfunkanbietern herangezogen. Die Kombination dieser verschiedenen Datenquellen ermöglicht eine umfassende und aktuelle Darstellung des Straßenzustands. **
Wie können Informationen effizient aus unstrukturierten Datenquellen extrahiert werden?
Durch den Einsatz von Text Mining und Natural Language Processing Technologien können unstrukturierte Daten analysiert und strukturiert werden. Algorithmen wie Machine Learning können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen. Zudem können spezielle Tools und Softwarelösungen wie Data Mining Software oder Business Intelligence Plattformen eingesetzt werden, um die Extraktion von Informationen zu automatisieren und zu optimieren. **


Ähnliche Suchbegriffe für Datenquellen
Top-Angebote
Produkte zum Begriff Datenquellen:
-
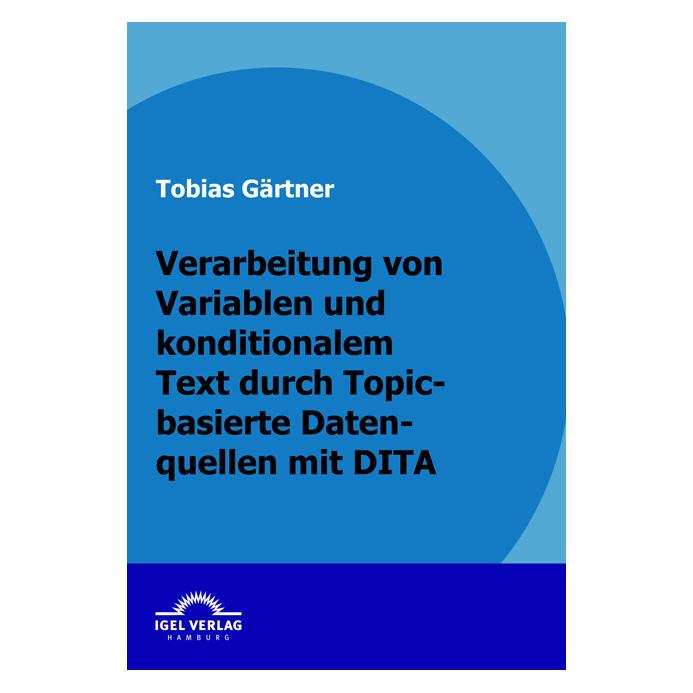
Igel Records Verarbeitung von Variablen und konditionalen Text durch Topic-basierte Datenquellen mit DITA (Deutsch, Softcover, Tobias Gärtner) (8290455)Igel Records Verarbeitung von Variablen und konditionalen Text durch Topic-basierte Datenquellen mit DITA (Deutsch, Softcover, Tobias Gärtner) (8290455)39,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
CannabisCannabis , Cannabis - von A wie Anbau bis Z wie Zulassung Bereits in der Antike wurde Cannabis als Arzneimittel eingesetzt - doch erst jüngst avancierte es zu einem der spannendsten medizinisch-pharmazeutischen Themen der Gegenwart. In kaum einem Bereich der Pharmakotherapie entwickelte sich der Erkenntnisstand zuletzt mit vergleichbarer Dynamik. Fachleute aus unterschiedlichen Tätigkeitsfeldern arbeiten kontinuierlich daran, neue wissenschaftliche Evidenz für den therapeutischen Einsatz von Cannabis bzw. Cannabinoiden zu generieren und Patienten mit qualitätsgesicherten Cannabisarzneimitteln zu versorgen. In diesem Werk haben erstmals Vertreter aller relevanten Fachbereiche mitgewirkt, die zu folgenden Themen Position beziehen: Geschichte | Botanik | Biosynthese | Zucht und Anbau | Import | Lieferkette | Qualitätssicherung und Qualitätskontrolle | Pharmakologie | Biopharmazie und Pharmakokinetik | Indikationen und Evidenz der Pharmakotherapie | Risiken und Nebenwirkungen | Fahrsicherheit | rechtlicher Status cannabinoidhaltiger Arzneimittel und Nichtarzneimittel | Darreichungsformen und Applikationsarten | Konsumformen im Freizeitgebrauch | Identitätsprüfung von Ausgangsstoffen | Herstellung von Rezeptur- und Defekturarzneimitteln | Belieferung von Cannabisrezepten | Kostenerstattung und Taxation | BtM-Recht und -Dokumentation | Rechtliche Rahmenbedingungen der Versorgung | Patientenberatung Dank dieser geballten Expertise erwuchs ein einzigartiges Gesamtbild, das den aktuellen rechtlichen und wissenschaftlichen Rahmen der medizinischen Cannabisversorgung erstmalig konsolidiert zusammenfasst! Alle Fakten wurden gewissenhaft recherchiert und überprüft. Entstanden ist ein wissenschaftlich valides Werk, das Maßstäbe setzt. Für alle, die sich aus beruflichen oder persönlichen Gründen mit Cannabis befassen, ist dieses ausgezeichnete Kompendium unverzichtbar! , Sonstige > Autopflege & Aufbereitung , Erscheinungsjahr: 20220905, Produktform: Leinen, Redaktion: Ziegler, Andreas S., Seitenzahl/Blattzahl: 527, Abbildungen: 275 farbige Abbildungen, 83 farbige Tabellen, Keyword: Anbau; Apotheke; Applikation; Behandlung; Beratung in der Apotheke; Biopharmazie; Biosynthese; Blüten und Extrakte; Botanik; Cannabidiol; Cannabinoide; Cannabis als Medizin; Darreichungsformen; Defektur; Evidenz; Freizeitkonsum; Geschichte; Herstellung; Indikationen; Kostenerstattung; Pharmakokinetik; Pharmakologie Cannabis; Qualität; Recht; Rezeptbelieferung; Rezeptur, Fachschema: Schweiz~Arznei / Recht, Zulassung~Arzneimittelgesetz - AMG~Medizin / Recht, Kriminalität~Apotheke - Apotheker~Pharmazie~Rote Liste (Arznei)~Recht~Arznei / Arzneimittellehre~Pharmakologie, Fachkategorie: Chemische, biotechnologische & pharmazeutische Industrie~Pharmazie- und Apothekenrecht~Medizinrechtliche Fragen~Klinische und Innere Medizin~Pharmazie, Apotheke~Pharmakologie, Region: Österreich~Deutschland~Schweiz, Sprache: Deutsch, Warengruppe: HC/Pharmazie/Pharmakologie/Toxikologie, Fachkategorie: Arzneimittel- und Medizinprodukterecht, Thema: Verstehen, Text Sprache: ger, Seitenanzahl: XV, Seitenanzahl: 527, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Wissenschaftliche, Verlag: Wissenschaftliche, Verlag: Wissenschaftliche Verlagsgesellschaft mbH, Blätteranzahl: 576 Blätter, Länge: 275, Breite: 203, Höhe: 32, Gewicht: 1500, Produktform: Gebunden, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Kennzeichnung von Titeln mit einer Relevanz > 30, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0020, Tendenz: -1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, WolkenId: 2868653108,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Verarbeitung von Variablen und konditionalen Text durch Topic-basierte Datenquellen mit DITA, Taschenbuch von Tobias Gärtner, Igel Verlag Literatur &Verarbeitung Von Variablen Und Konditionalen Text Durch Topic-basierte Datenquellen Mit Dita, Taschenbuch Von Tobias Gärtner, Igel Verlag Literatur & Wissenschaft, 978-3-86815-235-7, Seitenanzahl: 7639,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Eine Studie zu Microarray-Datenquellen und deren Verwaltung, Taschenbuch von Chirag Patel,Himanshu Pandya,Devarshi Mehta, Verlag Unser WissenEine Studie Zu Microarray-datenquellen Und Deren Verwaltung, Taschenbuch Von Chirag Patel,himanshu Pandya,devarshi Mehta, Verlag Unser Wissen, Seitenanzahl: 9666,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Was sind mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen?
Mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen können unterschiedliche Datenformate, fehlerhafte Datenübertragung oder -verarbeitung sowie Inkonsistenzen in den Datenquellen selbst sein. Diese Inkongruenzen können auch durch menschliche Fehler, veraltete Daten oder unvollständige Datensätze verursacht werden. Um Inkongruenzen zu vermeiden, ist es wichtig, Datenquellen regelmäßig zu überprüfen, Datenstandards zu definieren und Datenintegrationstechnologien zu verwenden. **
-
Wie werden Einkommensstatistiken erstellt und welche Datenquellen werden dafür verwendet?
Einkommensstatistiken werden in der Regel von staatlichen Behörden oder Statistikämtern erstellt. Zur Datenerhebung werden verschiedene Quellen genutzt, wie z.B. Steuererklärungen, Sozialversicherungsdaten, Umfragen oder administrative Daten von Unternehmen. Die gesammelten Daten werden analysiert und aufbereitet, um Informationen über Einkommen und Einkommensverteilung in der Bevölkerung zu liefern. **
-
Was sind die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen?
Die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen sind Inkonsistenzen in der Datenerfassung, unterschiedliche Datenformate und -strukturen sowie menschliche Fehler bei der Datenübertragung. Diese Diskrepanzen können zu falschen Analysen und Entscheidungen führen. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
Top-Angebote
Produkte zum Begriff Datenquellen:
-
Herausforderung im effizienten Umgang mit Daten unter Berücksichtigung von unterschiedlichen Datenquellen, Taschenbuch von Hans Schätzle, GRIN,Herausforderung Im Effizienten Umgang Mit Daten Unter Berücksichtigung Von Unterschiedlichen Datenquellen, Taschenbuch Von Hans Schätzle, Grin, 978-3-346-59698-7, Seitenanzahl: 3617,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Igel Records Verarbeitung von Variablen und konditionalen Text durch Topic-basierte Datenquellen mit DITA (Deutsch, Softcover, Tobias Gärtner) (8290455)Igel Records Verarbeitung von Variablen und konditionalen Text durch Topic-basierte Datenquellen mit DITA (Deutsch, Softcover, Tobias Gärtner) (8290455)39,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
CannabisCannabis , Cannabis - von A wie Anbau bis Z wie Zulassung Bereits in der Antike wurde Cannabis als Arzneimittel eingesetzt - doch erst jüngst avancierte es zu einem der spannendsten medizinisch-pharmazeutischen Themen der Gegenwart. In kaum einem Bereich der Pharmakotherapie entwickelte sich der Erkenntnisstand zuletzt mit vergleichbarer Dynamik. Fachleute aus unterschiedlichen Tätigkeitsfeldern arbeiten kontinuierlich daran, neue wissenschaftliche Evidenz für den therapeutischen Einsatz von Cannabis bzw. Cannabinoiden zu generieren und Patienten mit qualitätsgesicherten Cannabisarzneimitteln zu versorgen. In diesem Werk haben erstmals Vertreter aller relevanten Fachbereiche mitgewirkt, die zu folgenden Themen Position beziehen: Geschichte | Botanik | Biosynthese | Zucht und Anbau | Import | Lieferkette | Qualitätssicherung und Qualitätskontrolle | Pharmakologie | Biopharmazie und Pharmakokinetik | Indikationen und Evidenz der Pharmakotherapie | Risiken und Nebenwirkungen | Fahrsicherheit | rechtlicher Status cannabinoidhaltiger Arzneimittel und Nichtarzneimittel | Darreichungsformen und Applikationsarten | Konsumformen im Freizeitgebrauch | Identitätsprüfung von Ausgangsstoffen | Herstellung von Rezeptur- und Defekturarzneimitteln | Belieferung von Cannabisrezepten | Kostenerstattung und Taxation | BtM-Recht und -Dokumentation | Rechtliche Rahmenbedingungen der Versorgung | Patientenberatung Dank dieser geballten Expertise erwuchs ein einzigartiges Gesamtbild, das den aktuellen rechtlichen und wissenschaftlichen Rahmen der medizinischen Cannabisversorgung erstmalig konsolidiert zusammenfasst! Alle Fakten wurden gewissenhaft recherchiert und überprüft. Entstanden ist ein wissenschaftlich valides Werk, das Maßstäbe setzt. Für alle, die sich aus beruflichen oder persönlichen Gründen mit Cannabis befassen, ist dieses ausgezeichnete Kompendium unverzichtbar! , Sonstige > Autopflege & Aufbereitung , Erscheinungsjahr: 20220905, Produktform: Leinen, Redaktion: Ziegler, Andreas S., Seitenzahl/Blattzahl: 527, Abbildungen: 275 farbige Abbildungen, 83 farbige Tabellen, Keyword: Anbau; Apotheke; Applikation; Behandlung; Beratung in der Apotheke; Biopharmazie; Biosynthese; Blüten und Extrakte; Botanik; Cannabidiol; Cannabinoide; Cannabis als Medizin; Darreichungsformen; Defektur; Evidenz; Freizeitkonsum; Geschichte; Herstellung; Indikationen; Kostenerstattung; Pharmakokinetik; Pharmakologie Cannabis; Qualität; Recht; Rezeptbelieferung; Rezeptur, Fachschema: Schweiz~Arznei / Recht, Zulassung~Arzneimittelgesetz - AMG~Medizin / Recht, Kriminalität~Apotheke - Apotheker~Pharmazie~Rote Liste (Arznei)~Recht~Arznei / Arzneimittellehre~Pharmakologie, Fachkategorie: Chemische, biotechnologische & pharmazeutische Industrie~Pharmazie- und Apothekenrecht~Medizinrechtliche Fragen~Klinische und Innere Medizin~Pharmazie, Apotheke~Pharmakologie, Region: Österreich~Deutschland~Schweiz, Sprache: Deutsch, Warengruppe: HC/Pharmazie/Pharmakologie/Toxikologie, Fachkategorie: Arzneimittel- und Medizinprodukterecht, Thema: Verstehen, Text Sprache: ger, Seitenanzahl: XV, Seitenanzahl: 527, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Wissenschaftliche, Verlag: Wissenschaftliche, Verlag: Wissenschaftliche Verlagsgesellschaft mbH, Blätteranzahl: 576 Blätter, Länge: 275, Breite: 203, Höhe: 32, Gewicht: 1500, Produktform: Gebunden, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Kennzeichnung von Titeln mit einer Relevanz > 30, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0020, Tendenz: -1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, WolkenId: 2868653108,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Welche Datenquellen werden zur Bereitstellung von aktuellen Straßeninformationen genutzt?
Zur Bereitstellung von aktuellen Straßeninformationen werden Datenquellen wie GPS-Daten von Fahrzeugen, Verkehrsüberwachungskameras und Sensoren an Straßeninfrastruktur genutzt. Zudem werden auch Daten von Verkehrsinformationsdiensten, Navigationssystemen und Mobilfunkanbietern herangezogen. Die Kombination dieser verschiedenen Datenquellen ermöglicht eine umfassende und aktuelle Darstellung des Straßenzustands. **
-
Wie können Informationen effizient aus unstrukturierten Datenquellen extrahiert werden?
Durch den Einsatz von Text Mining und Natural Language Processing Technologien können unstrukturierte Daten analysiert und strukturiert werden. Algorithmen wie Machine Learning können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen. Zudem können spezielle Tools und Softwarelösungen wie Data Mining Software oder Business Intelligence Plattformen eingesetzt werden, um die Extraktion von Informationen zu automatisieren und zu optimieren. **
-
Was sind mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen?
Mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen können unterschiedliche Datenformate, fehlerhafte Datenübertragung oder -verarbeitung sowie Inkonsistenzen in den Datenquellen selbst sein. Diese Inkongruenzen können auch durch menschliche Fehler, veraltete Daten oder unvollständige Datensätze verursacht werden. Um Inkongruenzen zu vermeiden, ist es wichtig, Datenquellen regelmäßig zu überprüfen, Datenstandards zu definieren und Datenintegrationstechnologien zu verwenden. **
-
Wie werden Einkommensstatistiken erstellt und welche Datenquellen werden dafür verwendet?
Einkommensstatistiken werden in der Regel von staatlichen Behörden oder Statistikämtern erstellt. Zur Datenerhebung werden verschiedene Quellen genutzt, wie z.B. Steuererklärungen, Sozialversicherungsdaten, Umfragen oder administrative Daten von Unternehmen. Die gesammelten Daten werden analysiert und aufbereitet, um Informationen über Einkommen und Einkommensverteilung in der Bevölkerung zu liefern. **
Ähnliche Suchbegriffe für Datenquellen
-
Verarbeitung von Variablen und konditionalen Text durch Topic-basierte Datenquellen mit DITA, Taschenbuch von Tobias Gärtner, Igel Verlag Literatur &Verarbeitung Von Variablen Und Konditionalen Text Durch Topic-basierte Datenquellen Mit Dita, Taschenbuch Von Tobias Gärtner, Igel Verlag Literatur & Wissenschaft, 978-3-86815-235-7, Seitenanzahl: 7639,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Eine Studie zu Microarray-Datenquellen und deren Verwaltung, Taschenbuch von Chirag Patel,Himanshu Pandya,Devarshi Mehta, Verlag Unser WissenEine Studie Zu Microarray-datenquellen Und Deren Verwaltung, Taschenbuch Von Chirag Patel,himanshu Pandya,devarshi Mehta, Verlag Unser Wissen, Seitenanzahl: 9666,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Schmerz in Psychiatrie und Neurologie, Taschenbuch von Karl M. Einhäupl,Markus Gastpar, Springer Berlin, 978-3-540-44353-7Schmerz In Psychiatrie Und Neurologie, Taschenbuch Von Karl M. Einhäupl,markus Gastpar, Springer Berlin, 978-3-540-44353-7, Seitenanzahl: 18074,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen?
Die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen sind Inkonsistenzen in der Datenerfassung, unterschiedliche Datenformate und -strukturen sowie menschliche Fehler bei der Datenübertragung. Diese Diskrepanzen können zu falschen Analysen und Entscheidungen führen. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.